你有没有遇到过这种情况:家里的智能音箱突然抽风,反复听不懂一句话,你却完全说不清它到底哪里出了问题。它没有报错提示,也不会告诉你"我在第三步误解了你的意思"。你只能看着它一遍遍重试,然后放弃。
现在把这个场景放大一万倍。今天的AI智能体已经能自己写代码、逛网页、订机票、修bug,一次任务可能要走几十步甚至几百步。可当它失败的时候,我们能看到的往往只是一堆冰冷的日志:走了47步,调用了8次命令,编辑了12次文件,最后状态显示"失败"。
这堆数字告诉不了你任何有用的东西。它就像医院给你一张体检报告,上面写着"心率90,血压正常,体温36.8",却没有一个医生告诉你到底哪里不对。
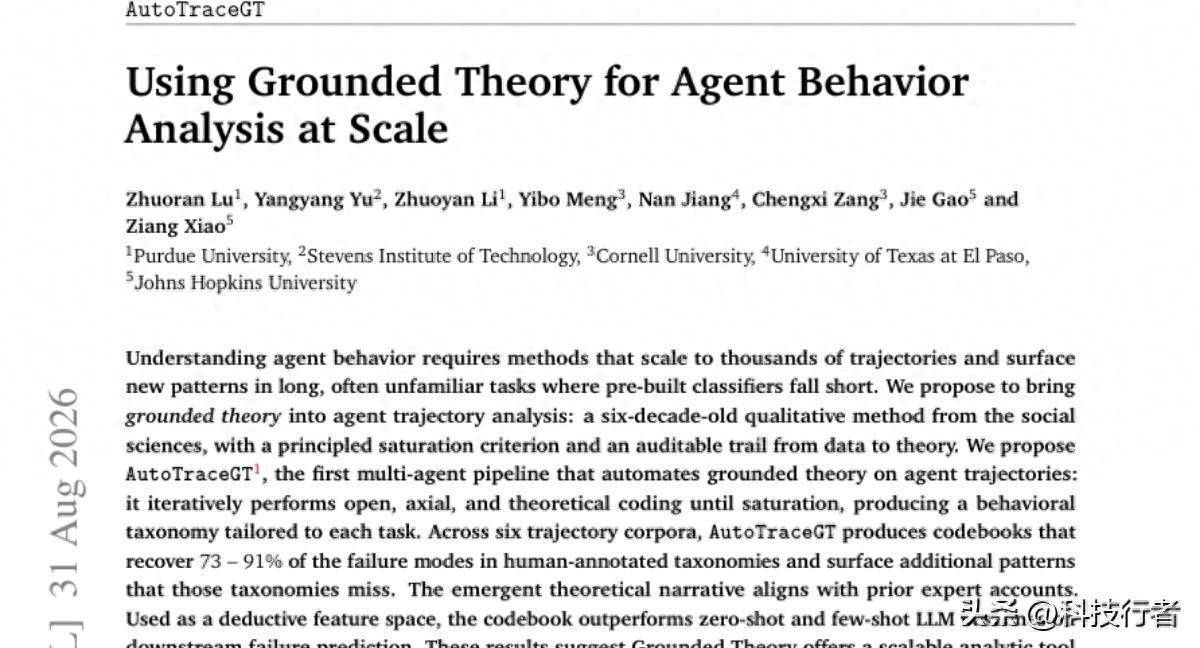
这就是2026年这篇名叫AutoTraceGT的论文想解决的问题。它的核心想法说起来挺大胆:把一个诞生于六十年前、社会学家专门用来研究人类行为的方法,搬过来给AI"看病"。
这个方法叫扎根理论。
扎根理论*:一种源自社会科学的定性研究方法,核心思想是让理论从原始数据里自己"长出来",而不是先有假设再去验证。研究者通过反复阅读、标注、归纳文本,逐步提炼出概念和理论。
这个方法1967年由两位社会学家格拉泽和斯特劳斯提出,原本是用来研究病房里护士和病人的互动、组织里员工的行为模式这类"说不清道不明"的社会现象。六十年后,它被搬进了AI实验室,用来研究一个同样说不清道不明的东西:智能体到底在想什么,又为什么会失败。
当前研究的两难
先说说这个领域现在卡在哪儿。
如果你去看AI智能体的评测榜单,比如专门测试软件工程能力的SWE-bench,或者测试网页操作能力的WebArena,你会发现它们给出的信息极其单薄:任务完成没完成,用了多少步,成功率多少。这类指标好处是能大规模自动统计,坏处是完全"看不见过程",专业说法叫process-blind
process-blind*:字面意思是"对过程视而不见",指一种评估方式只关心最终结果,却完全不记录、不分析中间发生了什么。
另一条路是靠人。研究者一行一行读智能体的操作日志,手工总结失败模式。这个办法的确管用,此前有一篇叫MAST的研究就是人工分析了150多条多智能体轨迹,总结出14种失败模式。问题是,这活儿太累了。一条轨迹可能有上百步,人工分析几千条根本不现实。
还有第三条路,介于两者之间:研究者先根据经验定好一套失败类型的分类表,比如"工具调用参数错误"、"计划执行不一致",然后让AI或规则去匹配打标签。这确实能规模化,但有个死穴:分类表是死的。碰到没见过的新任务、新的失败花样,这套表格立刻失灵。
这就好比你请了一个只认识五种蘑菇图片的鉴定师去森林里认蘑菇。他能认出这五种,剩下的一律说"未知",哪怕森林里真的长出了第六种、第七种蘑菇,他也识别不出来,更别说告诉你这第六种蘑菇具体长什么样、有什么特征。如果不解决这个"认知边界固化"的问题,AI行为分析就永远只能盯着已知的失败模式打转,那些真正新奇、真正值得研究的新行为反而被系统性地漏掉了。
论文的作者们意识到,扎根理论恰恰擅长解决这类"没有现成理论可套"的问题。它有三个特点特别对症:第一,它是归纳的,不预设分类,天然适合发现新东西;第二,它有一个叫"理论饱和"的停止标准,不是拍脑袋决定分析够不够,而是有一套可操作的判断依据;第三,它每一个结论都能倒查回原始数据,全程留痕,可审计。
理论饱和*:扎根理论里判断"分析可以停止"的标准,指的是当研究者继续采样新数据,却再也发现不了新的概念类别时,就说明现有的分类体系已经"饱和"了,足够全面。
把这套方法真正自动化,让它能跑在几千条轨迹上,这就是AutoTraceGT要干的事。
四个"AI侦探"分工破案
如果扎根理论是一整套破案流程,那AutoTraceGT就是给这套流程配了四个专职探员,各管一段。
第一个叫OpenCode,做开放编码。它的工作是逐条读智能体的操作轨迹,给每一段行为贴一个简短的概念标签,比如"寻找可用工具"或"在验证受阻后仍然坚持",同时附上具体是第几步、原文摘录是什么。这一步的关键是不能偷懒直接照抄操作名称,得提炼出"这属于哪种行为模式"。
轨迹*:指AI智能体从接到任务到完成或失败的全部过程记录,包含它的每一步操作、每一次观察和每一次决策推理。
举个例子。如果你只写"点击了送信按钮",这不算好标签,因为这只是复述发生了什么。但如果你写"没有核实就宣布任务完成",这就抓住了行为的性质,是"什么类型的问题",而不只是"发生了什么事"。这就像医生看病历,不能只写"病人咳嗽了三次",得写出"呼吸系统存在慢性刺激反应"这种能指导下一步判断的描述。
第二个探员叫AxialCode,做轴向编码。它把一批已经贴好标签的轨迹汇总起来,找出这些标签之间的共性,归并成更高层的类别,还要梳理这些类别之间的关系,比如谁是谁的前提条件,谁导致了谁。
第三个是幕后的管理者Manage,负责"持续比较"。它拿着每一轮新归纳出来的类别,去和已有的整体分类表对比,决定这个新类别该新增、合并、拆分,还是先标记存疑。它执行一个"先尝试合并"的策略,也就是说,只要新类别能塞进已有框架,就优先归并进去,而不是随手新开一条。
第四个是TheoreticalCode,做理论编码,在分类表稳定下来之后才登场,把所有类别整合成一套完整的叙事,指出哪个是核心矛盾,其他类别是它的前提、后果还是干扰因素。
这四个角色配合的方式,很像一个新闻编辑部的运作流程。记者(OpenCode)在现场一条一条采写事实,编辑(AxialCode)把这些零散的报道归纳成几条主题线,主编(Manage)审阅每篇稿子该不该并进已有专题、还是值得开新专题,最后总编(TheoreticalCode)在专题足够丰富之后,写一篇统摄全局的社论,点出这一切背后真正的核心问题是什么。如果没有这套分工,直接让一个模型一次性通读所有轨迹给结论,很可能只会得到一份浮于表面、缺乏证据链的总结,你根本没法追溯它凭什么这么说。
判断"够了"的数学标准
前面提到理论饱和是这套方法的灵魂,那具体怎么判断"够了"?
论文给出的操作化定义是:每一轮分析,如果新增的类别数量低于某个阈值ε,并且这个低新增状态连续维持了两轮,就认定饱和,分析可以停止。
这个设计背后有个很朴素的直觉:如果你不断喂给系统新的轨迹样本,它却越来越难找出新花样,反而越来越多是把新发现的行为"塞进"已有框架里合并、确认,那说明这套分类体系已经比较全面了,再看更多样本大概率也是重复劳动。
论文里的图4就展示了这个过程。随着分析轮次推进,"新增"类别的动作占比逐渐走低,而"合并"和"确认"的占比逐渐走高。分类表本身的规模也趋于稳定,与最终版本的相似度逐渐逼近1。这就跟你收拾一个凌乱房间很像:刚开始整理的时候,你会不断发现新的物品种类,衣服堆、书堆、杂物堆各自成类;可是收拾到后面,你翻出来的东西越来越多只是"又一件T恤"或"又一本笔记本",能归到已有的类别里,很少再冒出一个全新的物品种类需要单开一个抽屉。这时候你大概就知道,房间快收拾完了。
如果不设这个饱和标准,会怎样?此前的同类工作里,有的干脆固定跑几轮就停,完全不去验证分类表到底是不是真的"够全面"了。这样做的风险是,你根本不知道停下来的时候,分析质量是"刚刚好"还是"远远不够",或者反过来"过度分析、浪费资源"。饱和标准的意义就在于把这个模糊的、凭经验判断的停止时机,变成了一个可以复现、可以检验的数字规则。
作者们还专门验证了这套方法的稳定性靠不靠谱。他们在同一批数据、同一个模型配置下重复跑三次,结果发现同配置内的分类表相似度中位数达到0.929,远高于跨配置对比时0.901的高可靠性阈值。换成不同的底层大模型来跑同一批数据,得到的结果依然显著优于把数据集打乱重排后计算出的随机基准,统计检验的p值都小于0.001。这说明这套方法挖出来的结构,是数据本身自带的规律,而不是某个特定AI模型自己的思维习惯投射上去的幻觉。
这个验证很重要,因为如果换个模型结果就变了样,那你就不知道自己看到的到底是"智能体真实的行为模式
天顺优配提示:文章来自网络,不代表本站观点。